Evaluar el rendimiento de un proveedor de servicios tecnológicos es uno de los desafíos más complejos a los que se enfrentan las empresas actuales. Tradicionalmente, la calidad del soporte técnico se medía por el volumen: cuántos problemas se resolvían al mes o cuán rápido contestaba el teléfono el equipo de la mesa de ayuda. Sin embargo, en un entorno empresarial donde la tecnología es el núcleo de la operatividad, este enfoque reactivo ha quedado obsoleto.

Valorar a un proveedor de servicios IT gestionados basándote únicamente en el número de incidencias atendidas o en el importe de la cuota mensual es un error estratégico. Un alto volumen de tickets resueltos no significa que el proveedor sea eficiente; de hecho, a menudo indica que la infraestructura es inestable y que el enfoque proactivo está fallando. El verdadero valor de externalizar la gestión tecnológica reside en la prevención, la innovación y la alineación de la tecnología con los objetivos de negocio.

Para garantizar que la inversión tecnológica ofrezca un retorno real, los responsables de IT y la dirección financiera deben hablar un idioma común. El departamento técnico busca disponibilidad, seguridad y rendimiento, mientras que la dirección financiera persigue la optimización de costes, la rentabilidad y la reducción de riesgos corporativos. La única forma de tender un puente entre ambas visiones es mediante la implementación de un cuadro de mando MSP (Managed Service Provider) basado en datos objetivos, medibles y orientados a resultados.

En este artículo, desglosaremos los indicadores clave de rendimiento (KPI) que transforman la evaluación de un servicio técnico en una decisión estratégica, alejándonos de las métricas vanidosas para centrarnos en el impacto real sobre la productividad y las finanzas de tu organización.
El reto de alinear la visión técnica y la financiera

Cuando una empresa contrata servicios IT gestionados, el objetivo principal es dejar de apagar incendios diarios para empezar a innovar. Los equipos internos de IT suelen verse arrastrados en dos direcciones: quieren evaluar nuevas tecnologías y desplegar aplicaciones para apoyar el crecimiento del negocio, pero el día a día los consume con la gestión de copias de seguridad, parches de seguridad y resolución de problemas de los usuarios.

Externalizar estas tareas operativas a un proveedor experto devuelve el tiempo a tu equipo. Sin embargo, una vez delegada esta gestión, surge la pregunta crítica: ¿cómo sabemos si el proveedor está haciendo un buen trabajo?

Aquí es donde las perspectivas suelen chocar. Un Director de IT (CIO) puede estar satisfecho porque el proveedor ha implementado nuevas alertas de seguridad y el tiempo de respuesta inicial es rápido. Por el contrario, el Director Financiero (CFO) puede ver que la cuota mensual ha aumentado por servicios adicionales o que el coste derivado de las horas de inactividad de los empleados sigue lastrando la cuenta de resultados.

Para resolver esta desconexión, es imperativo establecer métricas que evalúen tanto la calidad del servicio técnico como la eficiencia económica. Un buen conjunto de KPI de servicios IT gestionados no solo mide lo que hace el proveedor, sino cómo lo que hace impacta en la empresa. Se trata de auditar la estabilidad, la velocidad de recuperación, la calidad de la atención al usuario final y la rentabilidad del modelo de soporte informático.

¿Tus servicios IT están ofreciendo el rendimiento que necesitas?

Obtén una visión clara de su eficiencia, costes y aportación al negocio con una gestión basada en KPIs.

Los 8 KPI fundamentales para evaluar a tu proveedor de servicios IT

A continuación, analizamos los ocho indicadores esenciales que deben configurar el núcleo de tu evaluación, diseñados para proporcionar una radiografía exacta del valor que aporta tu socio tecnológico.

1. Cumplimiento de SLA (Acuerdos de Nivel de Servicio)

El Acuerdo de Nivel de Servicio (SLA) es el contrato fundacional que establece las expectativas de rendimiento entre tu empresa y el proveedor. Sin embargo, medir el «cumplimiento de SLA» va mucho más allá de verificar si el servidor estuvo encendido el 99,9% del tiempo.

Este KPI debe desglosarse para evaluar el rigor del proveedor frente a diferentes niveles de criticidad. No es lo mismo el tiempo de respuesta para una consulta sobre cómo configurar una impresora (prioridad baja), que el tiempo de reacción ante una vulnerabilidad crítica en el servidor principal o una caída del ERP corporativo (prioridad crítica).


Por qué le importa a IT: Demuestra si el proveedor tiene la capacidad de priorizar adecuadamente y si cuenta con los recursos necesarios para escalar los problemas complejos (escalado técnico) sin cuellos de botella.

Por qué le importa a Finanzas: Un incumplimiento sistemático de los SLA, especialmente en sistemas críticos, se traduce directamente en lucro cesante. Además, los contratos maduros suelen incluir penalizaciones económicas por incumplimiento de SLA, lo que impacta en el coste real del servicio.

2. MTTR (Tiempo Medio de Resolución)

El MTTR de soporte informático (Mean Time To Resolve) es, posiblemente, la métrica técnica más crítica. Mide el tiempo promedio que transcurre desde que se reporta una incidencia hasta que esta queda completamente solucionada y el usuario o sistema vuelve a estar operativo.

Es vital no confundir el MTTR con el MTTA (Tiempo Medio de Respuesta o Acknowledgment). Un proveedor puede responder a un ticket en 5 minutos diciendo «Estamos revisando su caso» (un MTTA excelente), pero tardar tres días en solucionar el fallo de la base de datos (un MTTR deficiente). Lo que realmente impacta en la continuidad del negocio es el tiempo de resolución.


Por qué le importa a IT: Un MTTR bajo indica que el proveedor cuenta con técnicos altamente capacitados, herramientas de diagnóstico eficientes y una base de conocimientos sólida. Refleja la verdadera competencia técnica del equipo de soporte.

Por qué le importa a Finanzas: Cada minuto que un sistema clave está caído, la empresa pierde dinero. El MTTR permite al departamento financiero calcular el coste de inactividad (Downtime Cost) cruzando el tiempo medio de resolución con el coste por hora de los empleados afectados o la facturación perdida.

3. Resolución en primer contacto (FCR)

La tasa de resolución en primer contacto (First Contact Resolution o FCR) mide el porcentaje de incidencias que el service desk es capaz de solucionar en la primera llamada, chat o interacción con el usuario, sin necesidad de escalar el ticket a un técnico de nivel superior, requerir información adicional más adelante o devolver la llamada.

El FCR es el «santo grial» de la gestión de servicios (ITSM). Una tasa alta de FCR es el indicador más claro de que el proveedor ha asignado personal con la capacitación adecuada en la primera línea de soporte y de que posee herramientas de acceso remoto y automatización eficientes.


Por qué le importa a IT: Reduce drásticamente la carga de trabajo en los niveles de escalado técnico (Nivel 2 y Nivel 3), evitando que los ingenieros especializados pierdan tiempo en tareas rutinarias.

Por qué le importa a Finanzas: Es el factor que más abarata el soporte. Un ticket resuelto en primera instancia cuesta una fracción mínima en comparación con un ticket que escala por varios departamentos. Además, maximiza la productividad del empleado que reporta la incidencia, ya que vuelve a su trabajo casi de inmediato.

4. Coste por ticket IT

El coste por ticket IT es el indicador financiero por excelencia dentro del soporte informático. Se calcula dividiendo los costes operativos totales del servicio de soporte (incluyendo salarios, licencias de software ITSM, herramientas de monitorización, infraestructura y gastos generales del proveedor si es un modelo de pago por uso, o la parte proporcional de la cuota fija) entre el volumen total de tickets resueltos en un periodo determinado.

Es importante analizar esta métrica con cautela. Un coste por ticket extremadamente bajo no siempre es una buena noticia; puede indicar que el proveedor está resolviendo rápidamente problemas superficiales (como simples reseteos de contraseña) mientras ignora problemas estructurales complejos, o que está utilizando personal muy poco cualificado que ofrece una mala experiencia al usuario.


Por qué le importa a IT: Ayuda a justificar la inversión en automatización o en portales de autoservicio. Si el coste por ticket de «restablecimiento de contraseña» es alto, IT puede proponer implementar una herramienta de autogestión para los usuarios.

Por qué le importa a Finanzas: Permite evaluar la rentabilidad del contrato de externalización frente a mantener un equipo interno, y ayuda a proyectar los presupuestos de IT a medida que la empresa crece en número de empleados.

5. Tasa de reapertura de incidencias

De poco sirve tener un MTTR extraordinario y una alta resolución en primer contacto si los problemas vuelven a aparecer a las pocas horas. La tasa de reapertura mide el porcentaje de tickets que, tras ser marcados como «resueltos» por el proveedor, son reabiertos por el usuario porque el problema persiste o se ha reproducido.

Esta métrica es el principal control de calidad frente a las métricas de velocidad. Los proveedores bajo presión para cumplir los SLA de tiempo de resolución a veces cierran tickets prematuramente aplicando parches temporales en lugar de buscar la causa raíz del problema.


Por qué le importa a IT: Una alta tasa de reapertura es síntoma de falta de investigación de problemas subyacentes (Problem Management frente a Incident Management) y de una mala calidad en la ejecución técnica.

Por qué le importa a Finanzas: Las incidencias reabiertas generan frustración, duplican el esfuerzo operativo y ocultan ineficiencias graves por las que la empresa está pagando un servicio premium sin recibirlo.

6. Disponibilidad y salud de la infraestructura gestionada

Este KPI agrupa las métricas proactivas del servicio. En lugar de medir cómo reacciona el proveedor ante los fallos, mide su capacidad para evitarlos. Incluye indicadores como el uptime real de los servidores y redes, la tasa de éxito de las copias de seguridad diarias, el porcentaje de endpoints (ordenadores de usuarios) con el antivirus actualizado y el cumplimiento en la aplicación de parches de seguridad críticos.

En el contexto actual, donde normativas como la Directiva NIS2 exigen una gestión estricta de los riesgos de ciberseguridad, estas métricas demuestran si el proveedor mantiene la infraestructura blindada y resiliente.


Por qué le importa a IT: Verifica que las labores de mantenimiento preventivo y monitorización en la sombra se están ejecutando correctamente, garantizando la estabilidad y minimizando las alertas de seguridad.

Por qué le importa a Finanzas: Protege el activo más valioso de la empresa: la información. Un alto índice de salud de la infraestructura es la mejor póliza de seguro contra multas regulatorias y paralizaciones completas del negocio por ciberataques.

7. Backlog de tickets (envejecimiento de incidencias)

El backlog de tickets representa el volumen de incidencias abiertas que no se han resuelto dentro de los plazos establecidos y que se van acumulando. Más importante que el número total es el «envejecimiento» de estos tickets: cuántos llevan abiertos más de 3 días, 7 días o 30 días.

Un backlog creciente es una señal de alarma crítica. Indica que la capacidad operativa del proveedor está desbordada, que carecen del conocimiento técnico para resolver problemas complejos que se quedan atascados, o que hay problemas crónicos en la infraestructura de tu empresa que requieren inversión en hardware o software nuevo.


Por qué le importa a IT: Ayuda a identificar problemas sistémicos o áreas donde los usuarios necesitan más formación, así como a detectar si el proveedor carece de ingenieros de Nivel 3 suficientes.

Por qué le importa a Finanzas: Los tickets antiguos suelen corresponder a procesos bloqueados. Un backlog alto sostenido en el tiempo significa que la empresa está operando con fricciones constantes, reduciendo la eficiencia general.

8. Índice de Satisfacción del Cliente (CSAT) interno

Finalmente, no podemos olvidar la experiencia del usuario. El CSAT se mide generalmente a través de encuestas breves automatizadas tras el cierre de un ticket. Evalúa cómo perciben tus empleados el trato, la comunicación y la efectividad del soporte informático.

La tecnología está para servir a las personas. Un proveedor puede tener todos sus indicadores técnicos en verde, pero si los usuarios sienten que los técnicos son condescendientes, utilizan una jerga incomprensible o no explican las soluciones, el servicio está fracasando en su misión principal de facilitar el trabajo diario.


Por qué le importa a IT: Un CSAT bajo lleva a que los usuarios eviten usar el servicio de soporte y recurran al «Shadow IT» (resolver los problemas por su cuenta instalando software no autorizado), creando graves riesgos de seguridad.

Por qué le importa a Finanzas: La moral y la satisfacción de los empleados están directamente ligadas a la retención del talento y a la productividad. Un buen soporte tecnológico mejora el clima laboral.

Tabla resumen: Definición, cálculo y límites de los 8 KPI

Para que la dirección pueda evaluar rápidamente estos indicadores, es fundamental estandarizarlos. La siguiente tabla proporciona la estructura exacta para integrar estas métricas en tu cuadro de mando.

KPI

Definición

Fórmula de cálculo

Fuente de datos

Frecuencia de revisión

Límites / benchmarks recomendados

Cumplimiento de SLA

Porcentaje de incidencias gestionadas dentro de los plazos pactados.

(Tickets resueltos en SLA / Total de tickets) x 100

Plataforma ITSM del proveedor

Mensual

> 95% para incidencias generales; 100% para críticas.

MTTR (Resolución)

Tiempo promedio para solucionar una incidencia por completo.

Tiempo total de resolución de todas las incidencias / Volumen de incidencias

Plataforma ITSM

Mensual

< 4 horas para prioridad alta; < 8-12 horas para prioridad normal.

Resolución en primer contacto (FCR)

Porcentaje de tickets resueltos en la primera interacción, sin escalado técnico.

(Tickets resueltos en Nivel 1 en la primera llamada / Total de tickets) x 100

Plataforma ITSM / Registros de llamadas

Mensual

70% - 80%. Si es muy alto, puede indicar que las incidencias reportadas son demasiado básicas.

Coste por ticket IT

Gasto económico medio asociado a la resolución de cada incidencia.

Coste total operativo del soporte / Número total de tickets

ERP financiero + plataforma ITSM

Trimestral

Depende del sector, pero un rango saludable suele situarse entre 15 € y 35 € por ticket.

Tasa de reapertura

Porcentaje de tickets cerrados que el usuario vuelve a abrir.

(Tickets reabiertos / Total de tickets cerrados) x 100

Plataforma ITSM

Mensual

< 5%. Un valor superior suele reflejar problemas de calidad en la resolución.

Salud de infraestructura

Métrica compuesta que refleja el nivel de mantenimiento proactivo de la infraestructura, incluyendo parches, copias de seguridad y disponibilidad.

Media ponderada de: % de parches instalados, % de copias de seguridad exitosas, % de uptime

Herramientas RMM de monitorización

Semanal / Mensual

> 99% de éxito en copias de seguridad; > 98% en cumplimiento de parches.

Backlog de tickets

Volumen de tickets pendientes que ya han superado el tiempo de resolución esperado.

Número de tickets con estado «Abierto» cuya antigüedad supera el SLA base

Plataforma ITSM

Semanal

No debería superar el 10-15% del volumen semanal de tickets nuevos.

CSAT interno

Nivel de satisfacción de los usuarios tras su interacción con el soporte.

(Suma de puntuaciones / Total de encuestas respondidas) o % de valoraciones positivas

Sistema de encuestas post-ticket

Mensual

> 85% de satisfacción positiva. Tasa de respuesta a encuestas > 15%.

Ejemplo de estructura del Cuadro de Mando Ejecutivo

Imagina que abres tu cuadro de mando o dashboard el lunes por la mañana para tu reunión de evaluación mensual con el proveedor. La estructura ideal debería dividirse en tres niveles:

Dashboard Nivel 1


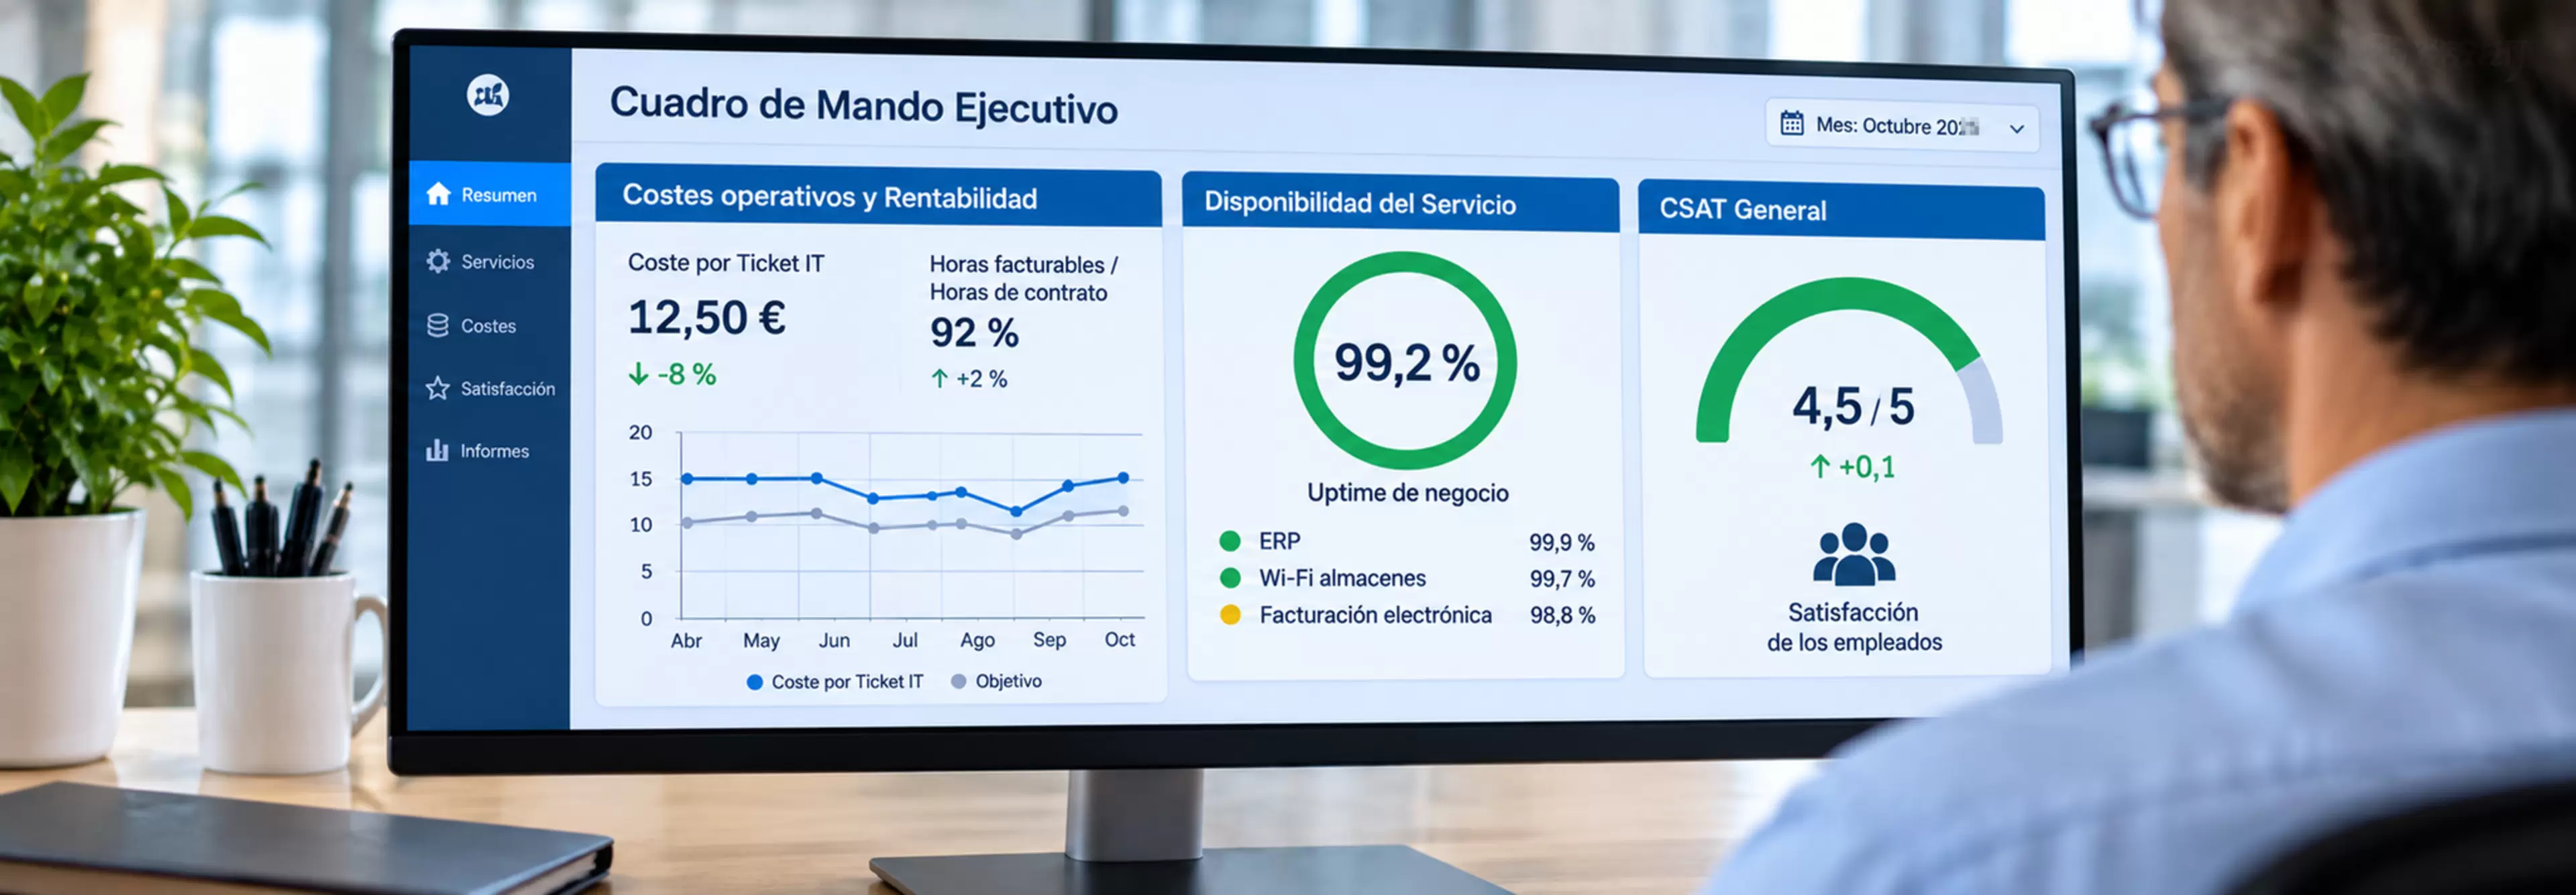
1. Visión Ejecutiva (Nivel Financiero y de Negocio)

  • Costes operativos y Rentabilidad: Muestra el Coste por Ticket IT mensual cruzado con las horas facturables vs. horas de contrato fijo. Si tu empresa opera con múltiples sedes, aquí debes ver la rentabilidad y el coste de soporte por cada sucursal.
  • Disponibilidad del Servicio (Uptime de negocio): Un semáforo visual (Verde/Ámbar/Rojo) que indica la disponibilidad de los servicios críticos (por ejemplo, el ERP, la red Wi-Fi de los almacenes y el sistema de facturación electrónica).
  • CSAT General: Un medidor claro de la satisfacción de los empleados.

Dashboard Nivel 2


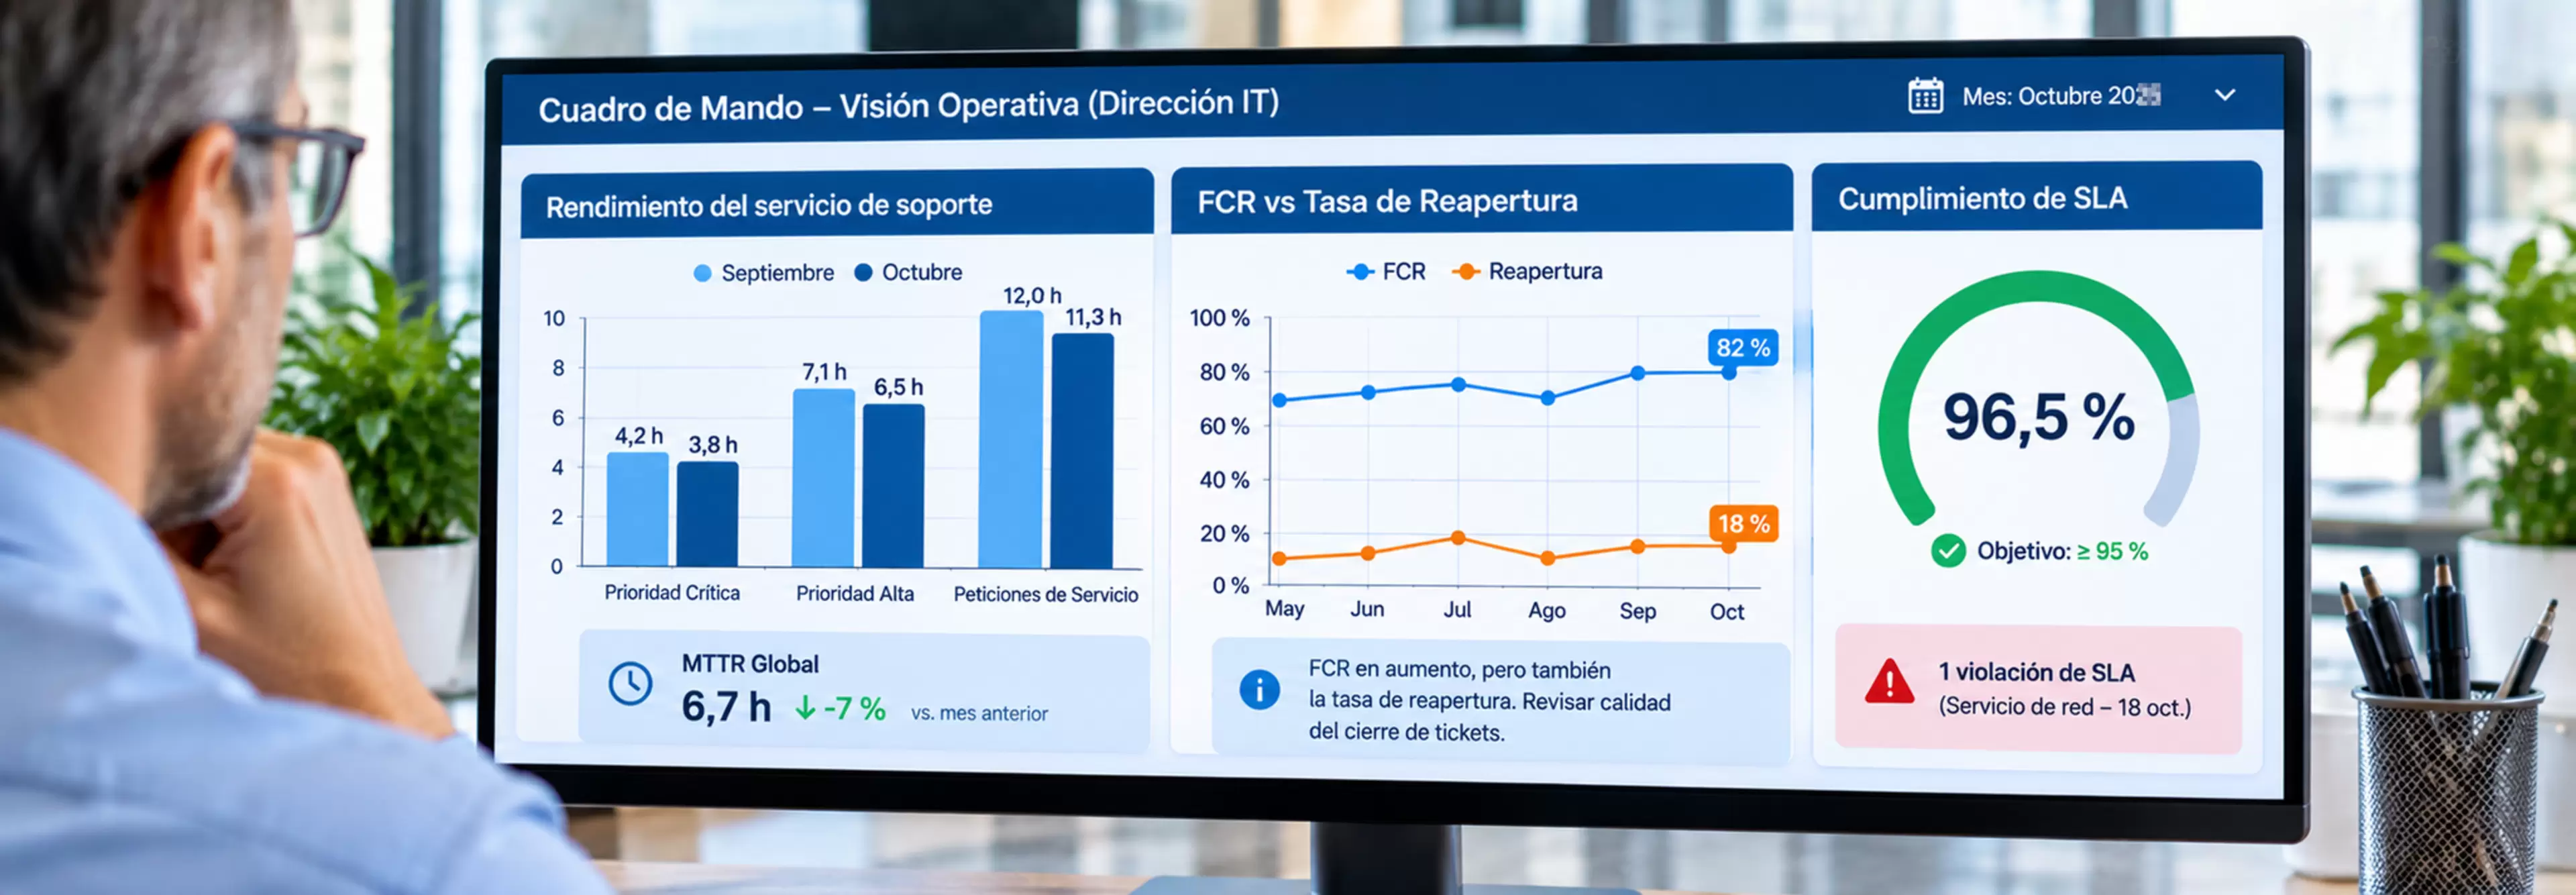
2. Visión Operativa (Nivel Dirección IT)

  • Rendimiento del servicio de soporte: Gráficos de barras que comparen el MTTR actual frente al mes anterior, segmentado por prioridad. Es vital separar las incidencias de «Prioridad Crítica» de las «Peticiones de Servicio» (como pedir un nuevo teclado).
  • FCR vs Tasa de Reapertura: Dos gráficos de líneas superpuestos. Si el FCR sube pero la tasa de reapertura también, el cuadro de mando te alerta visualmente de que el soporte está cerrando tickets en falso.
  • Cumplimiento de SLA: Porcentaje exacto de cumplimiento, destacando cualquier violación de SLA que deba ser discutida con el proveedor para posibles compensaciones.

Dashboard Nivel 3


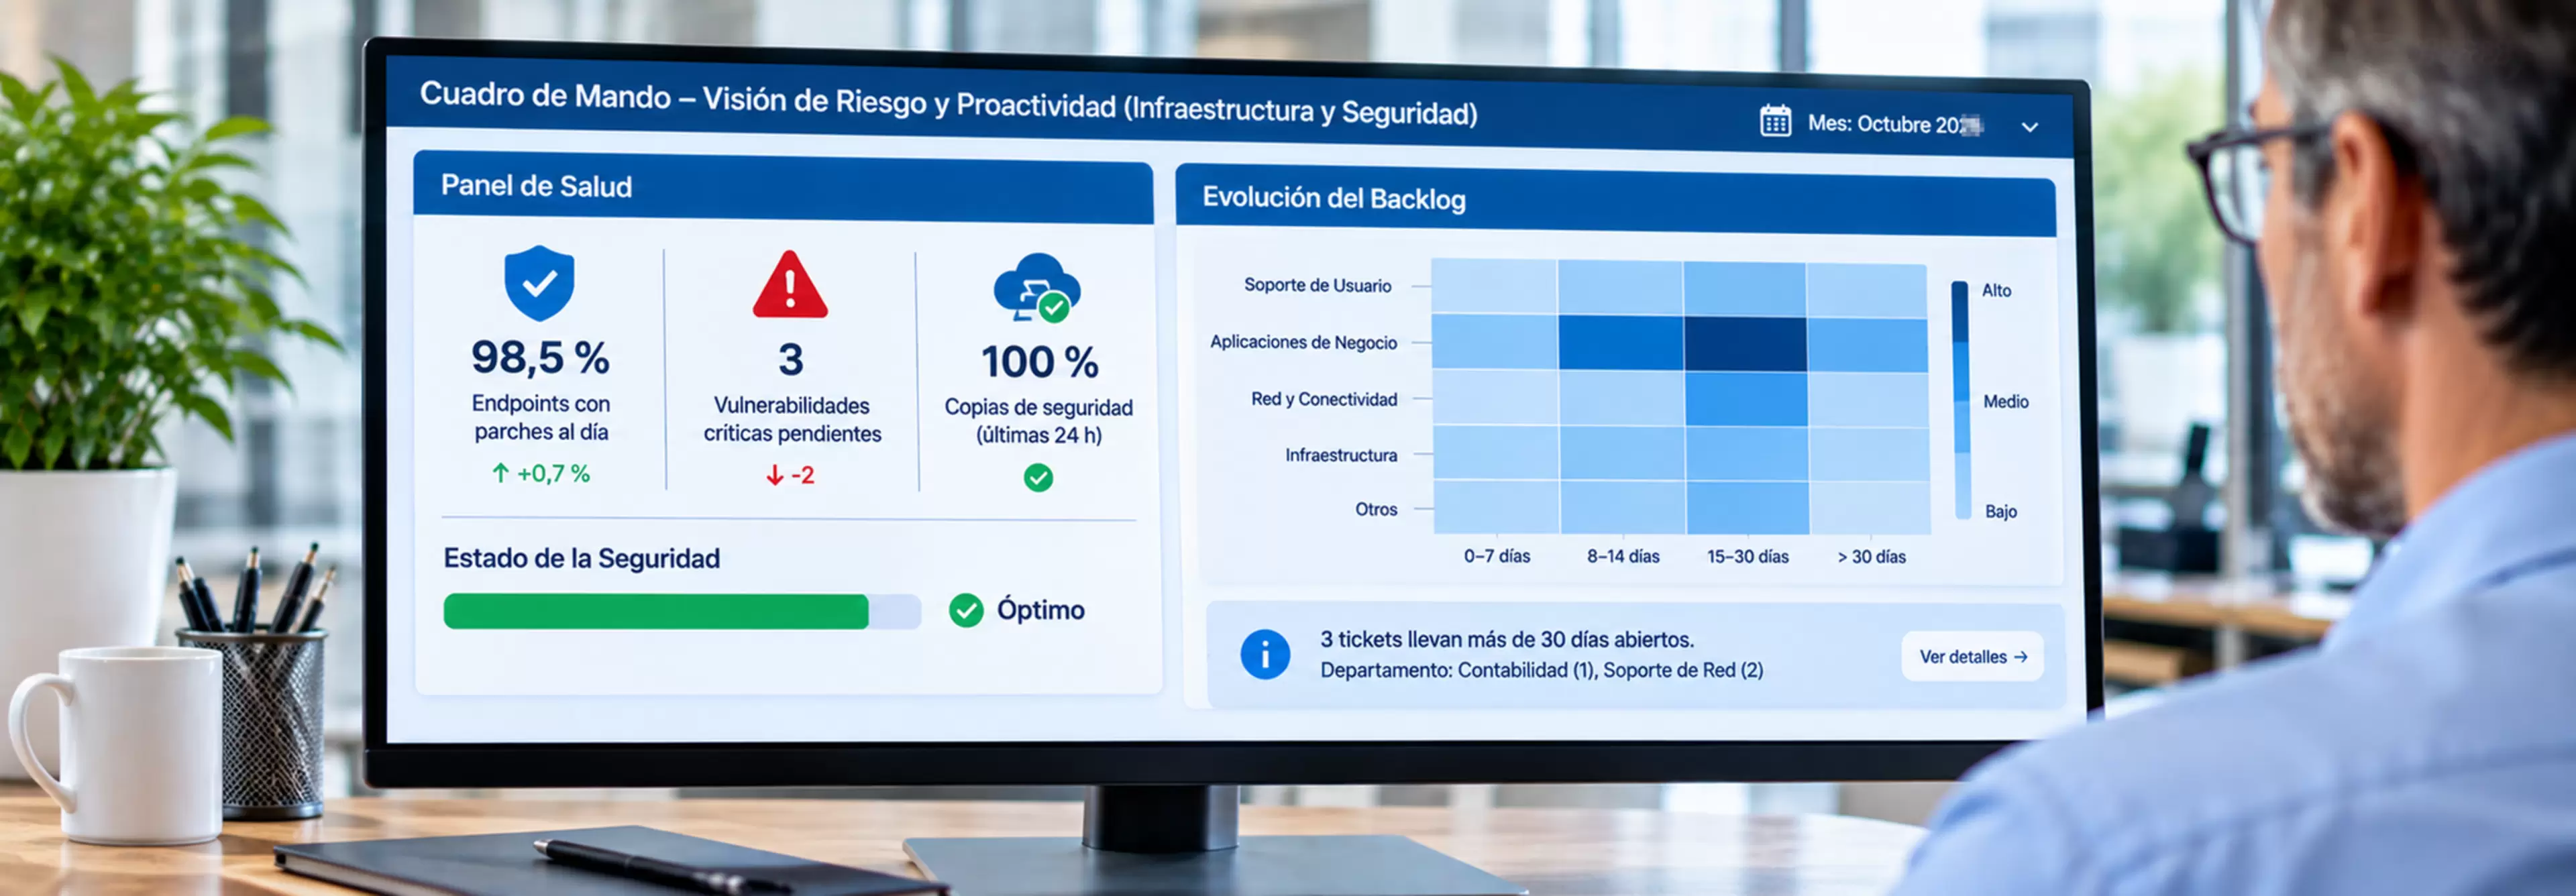
3. Visión de Riesgo y Proactividad (Nivel Infraestructura y Seguridad)

  • Panel de Salud: Porcentaje de endpoints con cumplimiento de parches, número de vulnerabilidades críticas pendientes de mitigar y estado diario de las copias de seguridad.
  • Evolución del Backlog: Un mapa de calor que muestra dónde se están atascando los tickets antiguos (¿es en el departamento de contabilidad debido a un software obsoleto? ¿es en el soporte de red?).

Esta segmentación transforma los datos en información procesable. Si el coste por ticket sube en el departamento de Recursos Humanos, el CFO puede investigar, y el CIO puede utilizar la métrica de FCR para demostrar que la causa es un software de nóminas problemático que requiere una actualización, justificando así una nueva inversión tecnológica basada en datos.

Columnas de un gráfico de barras en 3D de color naranja y azul sobre una superficie cuadriculada blanca

Preguntas frecuentes (FAQ) para la dirección IT y financiera

Para terminar de afinar la evaluación de tu proveedor de servicios gestionados, respondemos a las dudas estratégicas más comunes que surgen en los comités de dirección a la hora de interpretar estos KPI.

Al implementar estos 8 KPI y estructurar tu cuadro de mando bajo esta visión conjunta, dejas de ver los servicios IT gestionados como un gasto mensual obligatorio y pasas a gestionarlos como lo que verdaderamente son: un socio estratégico fundamental para la innovación, la seguridad y el crecimiento económico de tu negocio. Soluciones relacionadas como el soporte preventivo, la monitorización avanzada y el mantenimiento informático continuo solo revelan su auténtico valor cuando se miden con la precisión y el rigor de estos indicadores directivos.

¿Sabes si tus servicios IT están ofreciendo el rendimiento que necesitas?

Obtén una visión clara de su eficiencia, costes y aportación al negocio con una gestión basada en KPIs.

Compartir: